代理面板中的 omlx
oMLX 把你 Mac 上的模型提供给 termide 的代理,代理从它那里获取每个模型的窗口、显示预填充进度,并在会话中切换模型
oMLX 通过菜单栏应用在 Apple Silicon 上用 MLX 运行模型:一个服务器提供多个模型,按需加载,提示词缓存从内存溢出到 SSD,并且在重启后依然保留。它支持 OpenAI chat API,termide 的代理面板可以在它上面运行。
与 llama.cpp 一样,服务器不带自己的代理:代理由 termide 运行——它的系统提示词、工具、权限检查和上下文压缩——oMLX 负责回答模型调用。本指南介绍 oMLX 特有的部分;任何本地服务器共有的部分见 llama.cpp 指南。
准备工作
- Apple Silicon 的 Mac,macOS 15 或更高版本。
- oMLX:从其 发布页 下载应用,或使用 Homebrew(
brew tap jundot/omlx https://github.com/jundot/omlx和brew install jundot/omlx/omlx,然后omlx start)。服务器监听 8000 端口。 - 能调用工具的模型,从管理面板(
http://localhost:8000/admin)下载,或放进它的模型目录(~/.omlx/models):Qwen、GLM、Gemma 之类。代理只能通过工具调用工作。
添加连接
按 Alt+P 打开设置,进入 AI。最上面是 连接。+ 添加连接 会添加一个 OpenAI 兼容连接;在它的页面上:
- 基础 URL:
http://127.0.0.1:8000/v1。 - 模型:termide 向 oMLX 询问其模型,它会列出模型目录中的每一个,无论是否已加载。
- 上下文窗口(回退值):留空。oMLX 会报告每个模型的窗口,面板在启动时和每次切换模型时采用它,因此
Context:与服务器允许的一致。 - 同时请求数:保持不限制。oMLX 自己批量处理请求,默认一次最多八个;只有当你把
--max-concurrent-requests调低、需要让 termide 不超过它时才设置。 - API 密钥:oMLX 的主 API 密钥,除非你已为 localhost 关闭了验证。密钥存入 termide 的加密保险库,而不是
config.toml。 - 默认使用:勾选后,新的代理面板都会在 oMLX 上启动。
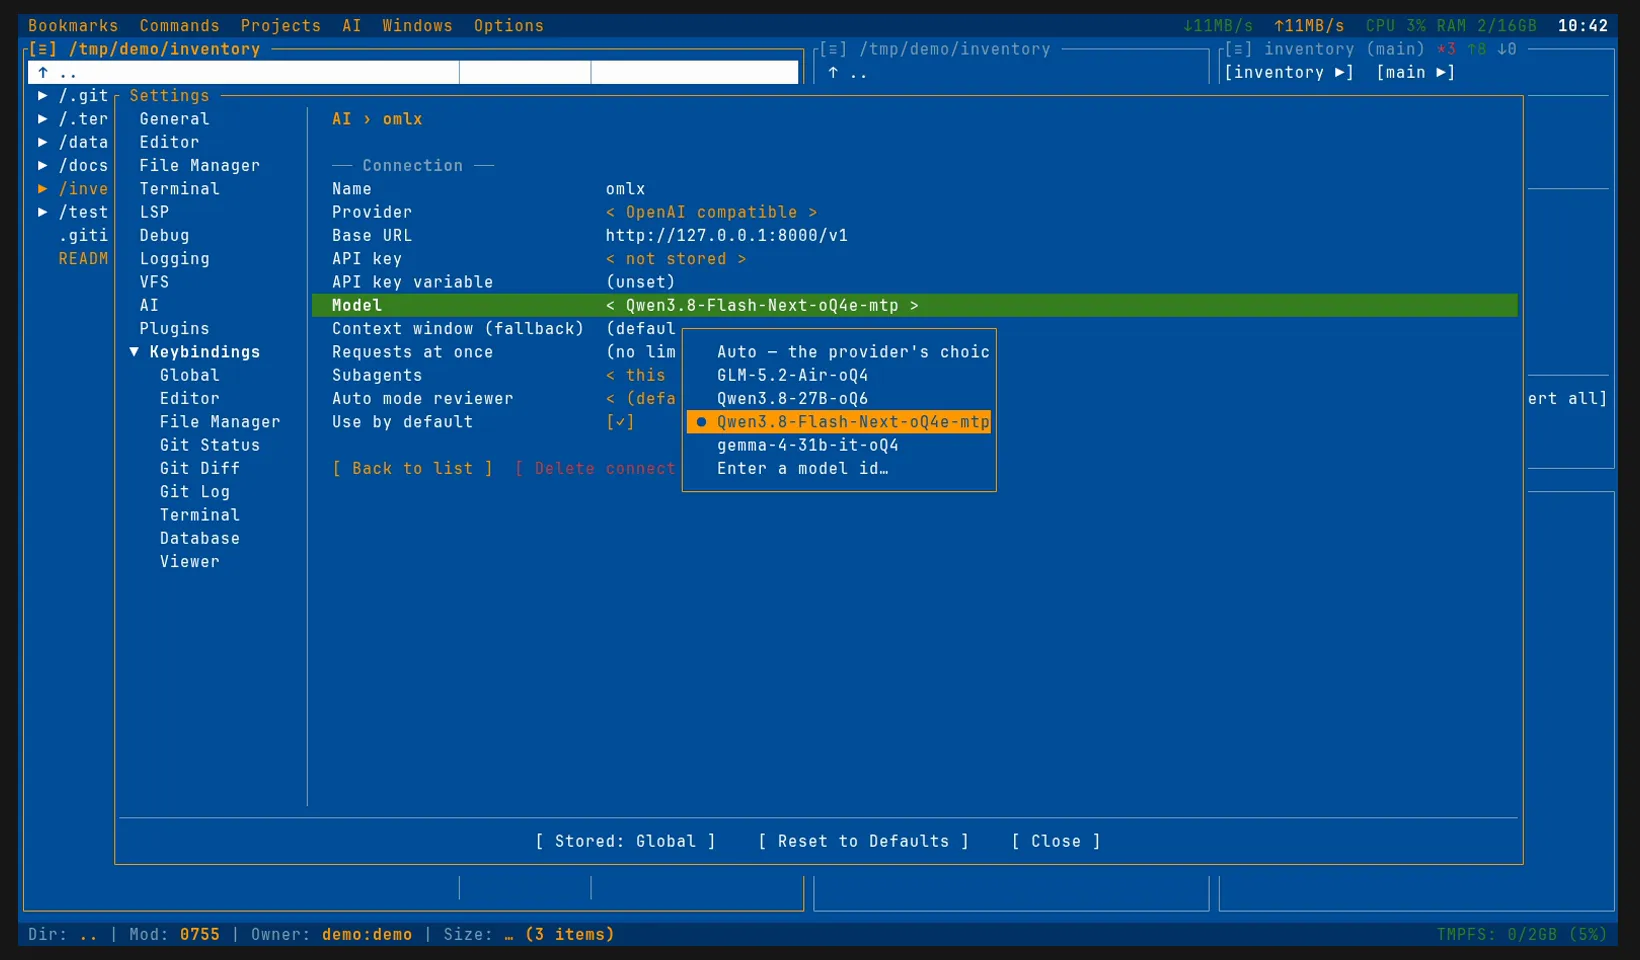
在 config.toml 中写法相同:
[ai]
connection = "omlx"                  # 新会话使用的连接

[ai.connections.omlx]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8000/v1"
model = "Qwen3.8-Flash-Next-oQ4e-mtp" # 留空:列表中的第一个模型
# api_key_env = "OMLX_API_KEY"       # 保存其主 API 密钥的变量
oMLX 也提供 Anthropic Messages API,但应该使用 OpenAI 兼容连接:termide 在那里读取模型窗口和预填充进度。
第一个请求
按 Alt+A 打开代理面板。在第一个 token 之前,面板显示预填充:oMLX 0.7.1 及以后版本会像 llama.cpp 一样报告提示词处理进度,面板据此绘制进度条,显示已读取的 token 数,以及未由缓存提供的部分的速度。较旧的 oMLX 则显示已用时间和提示词大小的估计。
推理 标签通过聊天模板的 enable_thinking 开关模型的思考;在同一个请求内,termide 每一步都会把模型的推理发回给它,与任何本地服务器上一样。
一个服务器,多个模型
状态栏中的 模型 标签列出服务器的模型,并在它们之间切换会话;切换从下一个请求起生效,并随会话保留。oMLX 在第一次被请求某个模型时加载它,因此那个请求也包含加载时间;内存不足时,它会卸载最久未使用的模型。在它的管理面板中固定你每天使用的模型,可以让它们保持加载。
列表中还能看到 oMLX 的两个特性:
- 别名。 在管理面板中设置了别名的模型会以别名列出。
- 配置档。 作为模型公开的配置档以
<模型>:<配置档>的形式列出,例如qwen3-8b:thinking:同一个已加载的模型加上配置档的设置,可以通过标签为会话选择。
oMLX 把提示词缓存保存在内存中,超出部分保存在 SSD 上,即使服务器重启也不会丢失。因此重新打开的长会话大部分提示词都从缓存读取,而不必重新处理:状态栏中表现为很大的 ↻ 旁边一个很小的 ↑。
用小模型做审查
在 auto 模式下,本该弹出权限卡片的操作由审查模型决定:每个这样的操作之前多一次请求。默认它在会话自己的模型上运行。使用 oMLX 时,同一服务器上的一个较小模型就能承担,无需运行第二个服务器:
[ai.auto_reviewer]
connection = "omlx"   # 留空:会话自己的连接
model = "gemma"       # 该连接的某个模型,按 id 或其一部分匹配
审查模型会与会话的模型一起保持加载,所以请为两者都留出内存。
其余都归 termide
其他一切与任何本地服务器上一样,llama.cpp 指南 逐一介绍了这些:termide 自己的系统提示词和工具、接近窗口时的上下文压缩、权限模式、服务器不可用或上下文已满时面板的处理,以及会话信息如何统计 token。
须知
- 服务器可以是另一台 Mac。 没有主 API 密钥时,oMLX 拒绝在回环地址之外监听:设置密钥,用
--host 0.0.0.0启动它,并把 基础 URL 指向那台 Mac。 - oMLX 只是一个例子。 同样的 OpenAI 兼容连接也适用于 llama.cpp、vLLM、Ollama、LM Studio,或 OpenAI、OpenRouter 这样的托管 API;
provider = "anthropic_compatible"则用于 Anthropic 兼容的 API。 - termide 不提供沙箱。 它的权限是一种控制手段,而不是隔离:你允许的操作以你的权限运行。
- 其他连接: Claude Code、Codex 和 Gemini CLI 自带代理和订阅;当它们的额度用完时,oMLX 连接是一个很好的备用连接,可以把会话切换过去。
- 详细说明 见 代理指南。