代理面板中的 llama.cpp
你自己机器上的模型通过 llama-server 驱动 termide 的代理,带有实时预填充进度条、由 termide 控制在窗口之内的上下文,以及由它分配的槽位
llama.cpp 在你自己的硬件上运行模型:没有订阅,没有额度,你发送的任何内容都不会离开这台机器。它的 llama-server 支持 OpenAI chat API,termide 的代理面板可以在它上面运行。
与 Claude Code、Codex 或 Gemini CLI 不同,模型服务器不带自己的代理。代理由 termide 自己运行:它的系统提示词、它的工具、它的权限检查和它的上下文压缩,llama-server 只负责回答模型调用。本指南介绍如何配置,以及 termide 专门为本地模型做了什么。
准备工作
- llama-server,来自 llama.cpp 的构建或软件包(例如
brew install llama.cpp)。 - 能调用工具的模型,GGUF 文件格式:Qwen、GLM、gpt-oss 之类。代理只能通过工具调用来读取、修改和运行命令,不支持工具调用的模型无法在面板中工作。
用你想要的窗口和一个简短的模型名启动服务器:
llama-server -m ~/models/Qwen3.6-35B-A3B-Q4_K_M.gguf \
--alias qwen3.6-35b-a3b -c 65536 --port 8080-c是上下文窗口。省略时 llama-server 使用模型自身的窗口,可能放不进内存;无论如何 termide 都需要这个数字(见下文)。--alias设置模型在 API 中的名称。没有它时,模型 id 是模型文件的路径。--jinja在当前构建中默认开启,它使用模型自带的聊天模板渲染,模型的工具调用正是靠它才能工作。
添加连接
按 Alt+P 打开设置,进入 AI。最上面是 连接。+ 添加连接 会添加一个 OpenAI 兼容连接,llama-server 正是这种;在它的页面上:
- 基础 URL:
http://127.0.0.1:8080/v1。 - 模型:termide 向服务器询问其模型;llama-server 列出它加载的那一个。
- 上下文窗口(回退值):启动服务器时的
-c。llama-server 不向 termide 报告自己的窗口,因此不填时面板假定为 32,000 个 token:窗口更大时会过早压缩,窗口更小时超出的请求会被服务器拒绝。 - 同时请求数:llama-server 一次运行多少个请求(见 槽位)。
- API 密钥:仅当你用
--api-key启动服务器时需要。密钥存入 termide 的加密保险库,而不是config.toml。 - 默认使用:勾选后,新的代理面板都会在 llama.cpp 上启动。
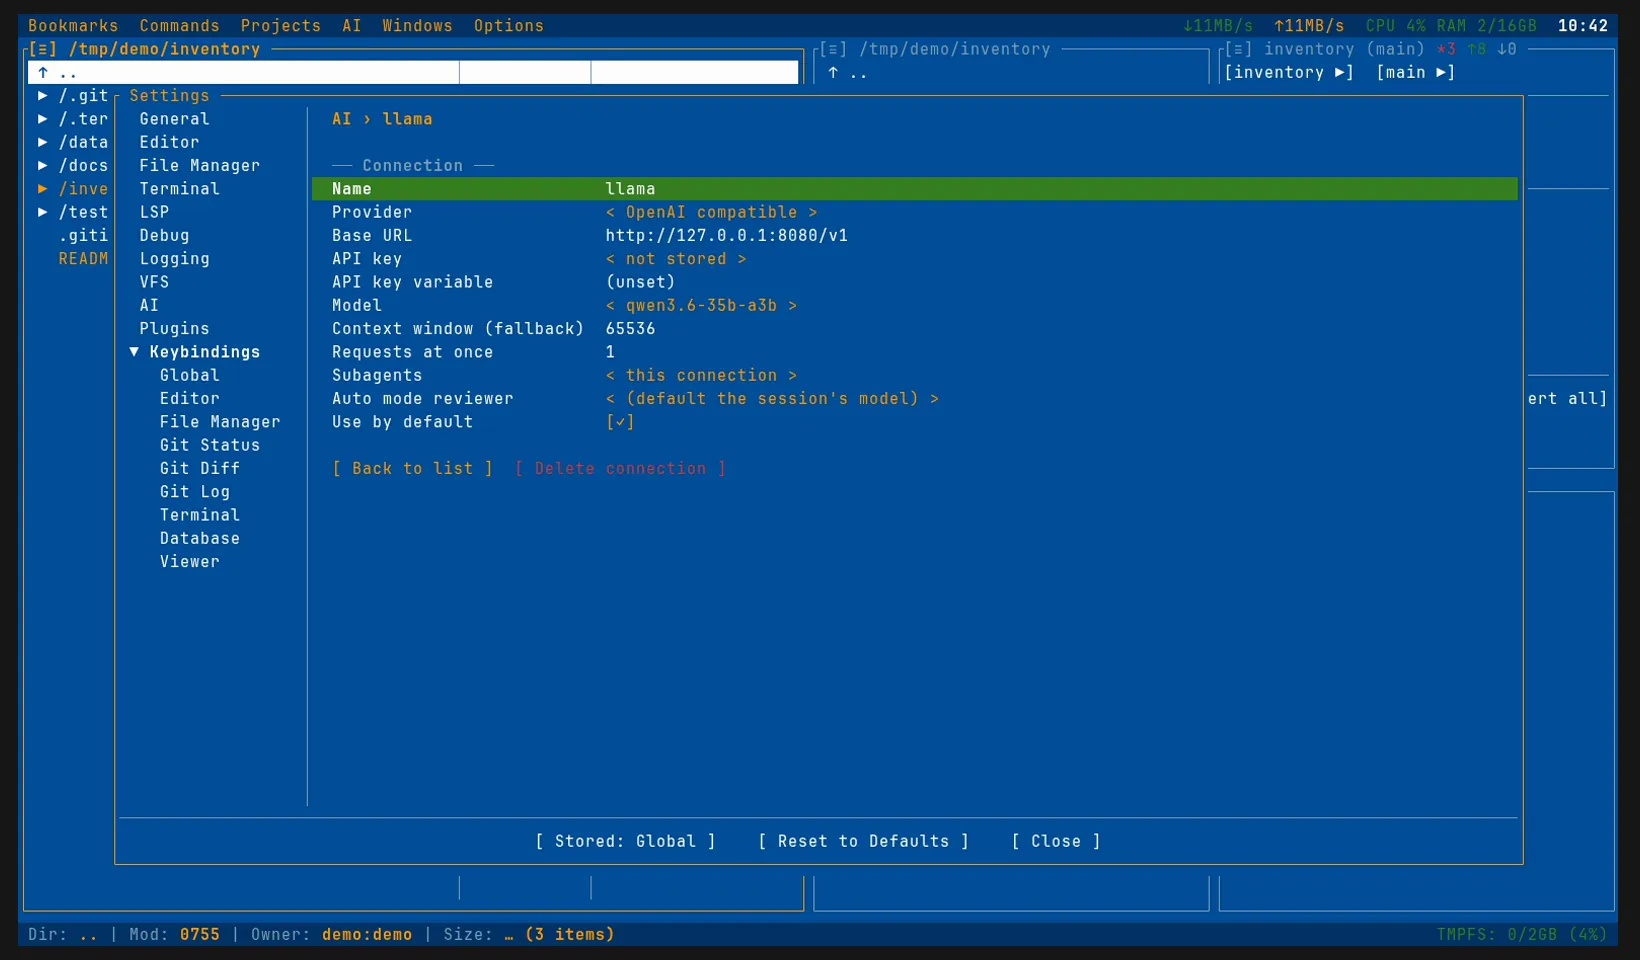
在 config.toml 中写法相同:
[ai]
connection = "llama"                 # 新会话使用的连接

[ai.connections.llama]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8080/v1"
model = "qwen3.6-35b-a3b"            # 即 --alias;留空:列表中的第一个模型
context_window_fallback = 65536      # llama-server 的 -c
max_concurrent_requests = 1          # 它的槽位数
# api_key_env = "LLAMA_API_KEY"      # 保存其 --api-key 的变量
第一个请求
按 Alt+A 打开代理面板。在模型的第一个 token 到来之前,面板会显示 llama-server 已读取了多少提示词:termide 请求提示词处理进度,llama-server 边处理边报告。
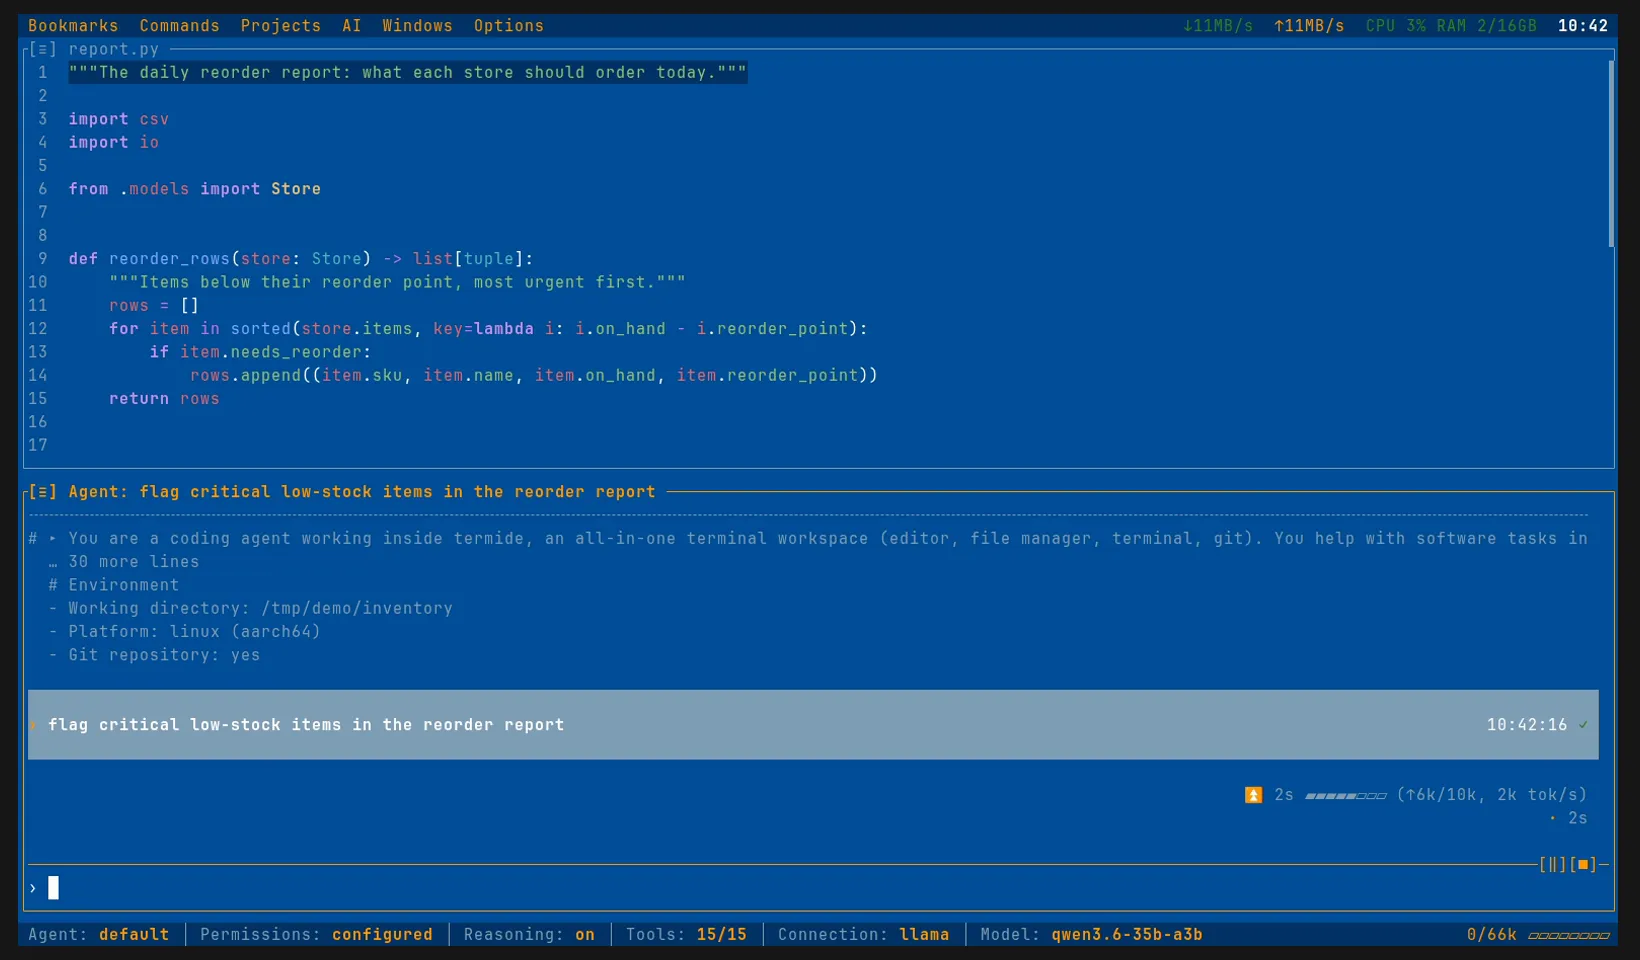
在本地模型上,预填充往往是最慢的部分:仅系统提示词和工具定义就有几千个 token,长会话则达到几万。llama-server 会把读过的内容留在缓存中,因此同一对话的下一个请求只需读取新增的部分,进度条也会显示这一点:↑360 而不是 ↑10k。完成的块会保留预填充和生成的数据:各自用了多长时间、多少 token、速度多快。
推理 标签用来开关模型的思考:termide 把它作为聊天模板的 enable_thinking 发送,Qwen、GLM 和 DeepSeek 的模板都会读取它。关闭时模型回答更快、花费的 token 更少;开启时它会先做规划,多步骤任务通常需要这样。在同一个请求内,termide 每一步都会把模型的推理发回给它,因此模型不会在读取和修改之间丢失自己的计划。
在代理工作时输入的消息会在下一步并入运行,/pause 会在步骤之间暂停运行。
termide 的代理,你的模型
代理所做的一切都属于 termide:系统提示词(它会读取你的 AGENTS.md)、工具——read、edit、shell、终端会话、网页、recall——你配置的 MCP 服务器、你的技能和权限规则。模型只负责选择调用什么。较小的模型在这方面比前沿模型更容易出错,因此权限卡片和 /undo 在这里更重要。
把上下文控制在窗口之内同样是 termide 的事。接近窗口时(窗口减去 reserve_tokens),termide 会让模型总结会话中较早的部分,最近的消息保持原样;/compact 可以随时手动触发:
[ai.compaction]
enabled = true              # 接近窗口时自动压缩
reserve_tokens = 16384      # 上下文超过窗口减去此值时开始
keep_recent_tokens = 4096   # 原样保留的最近消息
read 会把图片作为图像交给代理,因此截图需要带投影器的视觉模型(--mmproj,或由 -hf 一并下载);纯文本模型的服务器会拒绝这样的请求。
槽位
llama-server 同时运行的请求数等于它的槽位数(--parallel)。调用模型的不只是面板:委派任务、auto 审查、会话标题和其他面板也会调用。超出槽位数的请求要么在服务器上等待,要么占用另一段对话需要其缓存的槽位,那段对话就得重新读取整个提示词。
同时请求数(max_concurrent_requests)可以控制这一点:把它设为槽位数,其余请求由 termide 自己按先来先服务排队。排队中的请求显示 ⏳,以及已等待的时间和排在它前面的请求数,Esc 可以在它发送之前取消它。
使用 --parallel 时,各槽位共享 -c 窗口:除非服务器使用统一缓存(--kv-unified),每个槽位分到 -c 除以槽位数。上下文窗口(回退值) 是单个请求能用的大小,所以请填一个槽位分到的份额。
权限与 auto 模式
权限 标签(或 Shift+Tab)与任何连接上一样:ask、configured、plan、edit、all 和 auto,每个调用都由 termide 自己决定——这里没有服务器自己的代理模式可以映射。
在 auto 模式下,审查默认在会话自己的模型上运行:它决定的每个操作之前多一次请求,走同样的槽位。读取、项目内的修改和只查看的命令永远不会交给它。通常选一个小而快的模型:把它作为第二个 llama-server 运行,并把它的连接指定为此连接的审查者:
[ai.connections.llama]
# …
reviewer = "llama-small"             # 它的 auto 审查;默认:[ai.auto_reviewer]

[ai.connections.llama-small]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8081/v1"
context_window_fallback = 16384
max_concurrent_requests = 1
出错时
- 服务器停止或正在重启:运行以 无法连接模型 结束,卡片提供 立即重试、持续重试直到成功 和 停止。对于无人值守的
/goal或/loop,把 遇到限额或中断时([ai]下的on_limit)设为wait。 - 上下文已满:llama-server 拒绝超出其窗口的提示词,termide 会自行压缩会话并再试一次。如果仍然失败,卡片会提供 压缩上下文并重试。出现这种拒绝通常说明 上下文窗口(回退值) 设得比服务器实际的大。
会话与开销
没有账单,但 token 仍然消耗时间。会话信息(F3 或 /usage)按花费者——对话、子代理、auto 审查、总结——细分 token 用量,状态栏则在上下文及其窗口(11k/66k)旁统计会话的输入、缓存读取和输出(↑11k ↻30k ↓460)。↻ 相对 ↑ 越高,说明 llama-server 的缓存越有效。
须知
- 服务器也可以在别处。 租用机器上的 llama-server 用法相同:用
--host 0.0.0.0和--api-key启动它,并把 基础 URL 指向那里。termide 会把推理开关、进度请求和推理回传发给除 hosted API 之外的任何服务器,不论其地址,并省略服务器拒绝的字段。 - termide 不提供沙箱。 它的权限是一种控制手段,而不是隔离:你允许的操作以你的权限运行。
- llama.cpp 只是一个例子。 同样的 OpenAI 兼容连接也适用于 vLLM、Ollama、LM Studio,或 OpenAI、OpenRouter 这样的托管 API;
provider = "anthropic_compatible"则用于 Anthropic 兼容的 API。omlx 是另一个本地的例子,适用于 Mac。 - 其他连接: Claude Code、Codex 和 Gemini CLI 自带代理和订阅;当它们的额度用完时,llama.cpp 连接是一个很好的备用连接,可以把会话切换过去。
- 详细说明 见 代理指南。