llama.cpp в агентной панели
Модель на вашей машине работает в агенте termide через llama-server — с живой полоской prefill, контекстом, который termide держит в пределах окна, и слотами, которые он делит
llama.cpp запускает модель на вашем собственном железе: ни подписки, ни квоты, и ничего из отправленного не покидает машину. Его llama-server говорит на OpenAI chat API, и агентная панель termide умеет на нём работать.
В отличие от Claude Code, Codex или Gemini CLI, сервер модели своего агента не приносит. Агента ведёт сам termide: его системный промпт, его инструменты, его проверки разрешений и его сжатие контекста, а llama-server только отвечает на обращения к модели. Этот гайд показывает, как это настроить и что termide делает именно для локальной модели.
Что понадобится
- llama-server из сборки llama.cpp или из пакета (например,
brew install llama.cpp). - Модель, которая вызывает инструменты, в виде файла GGUF: Qwen, GLM, gpt-oss и подобные. Агент читает, правит и запускает команды только через вызовы инструментов, так что модель без них в панели работать не сможет.
Запустите сервер с нужным окном и коротким именем модели:
llama-server -m ~/models/Qwen3.6-35B-A3B-Q4_K_M.gguf \
--alias qwen3.6-35b-a3b -c 65536 --port 8080-c— контекстное окно. Без него llama-server возьмёт окно самой модели, которое может не поместиться в память; termide это число нужно в любом случае (см. ниже).--aliasзадаёт имя модели в API. Без него id модели — путь к её файлу.--jinja, включённый по умолчанию в современных сборках, применяет собственный шаблон чата модели — именно благодаря ему работают её вызовы инструментов.
Добавьте подключение
Откройте настройки клавишами Alt+P и перейдите на вкладку AI. Первым идёт раздел Подключения. + Добавить подключение добавляет OpenAI-совместимое — а llama-server именно такой; на его странице:
- Базовый URL:
http://127.0.0.1:8080/v1. - Модель: termide спрашивает у сервера его модели; llama-server показывает ту, что загрузил.
- Контекстное окно (запасное): значение
-c, с которым вы запустили сервер. llama-server не сообщает termide своё окно, поэтому без этого поля панель считает его равным 32 000 токенов: на большом окне она сожмёт разговор слишком рано, а на меньшем сервер отклонит запрос, который в него не влезет. - Запросов одновременно: сколько запросов llama-server выполняет за раз (см. Слоты).
- Ключ API: только если сервер запущен с
--api-key. Ключ уходит в зашифрованное хранилище termide, а не вconfig.toml. - Использовать по умолчанию: отметьте, и новые агентные панели будут открываться на llama.cpp.
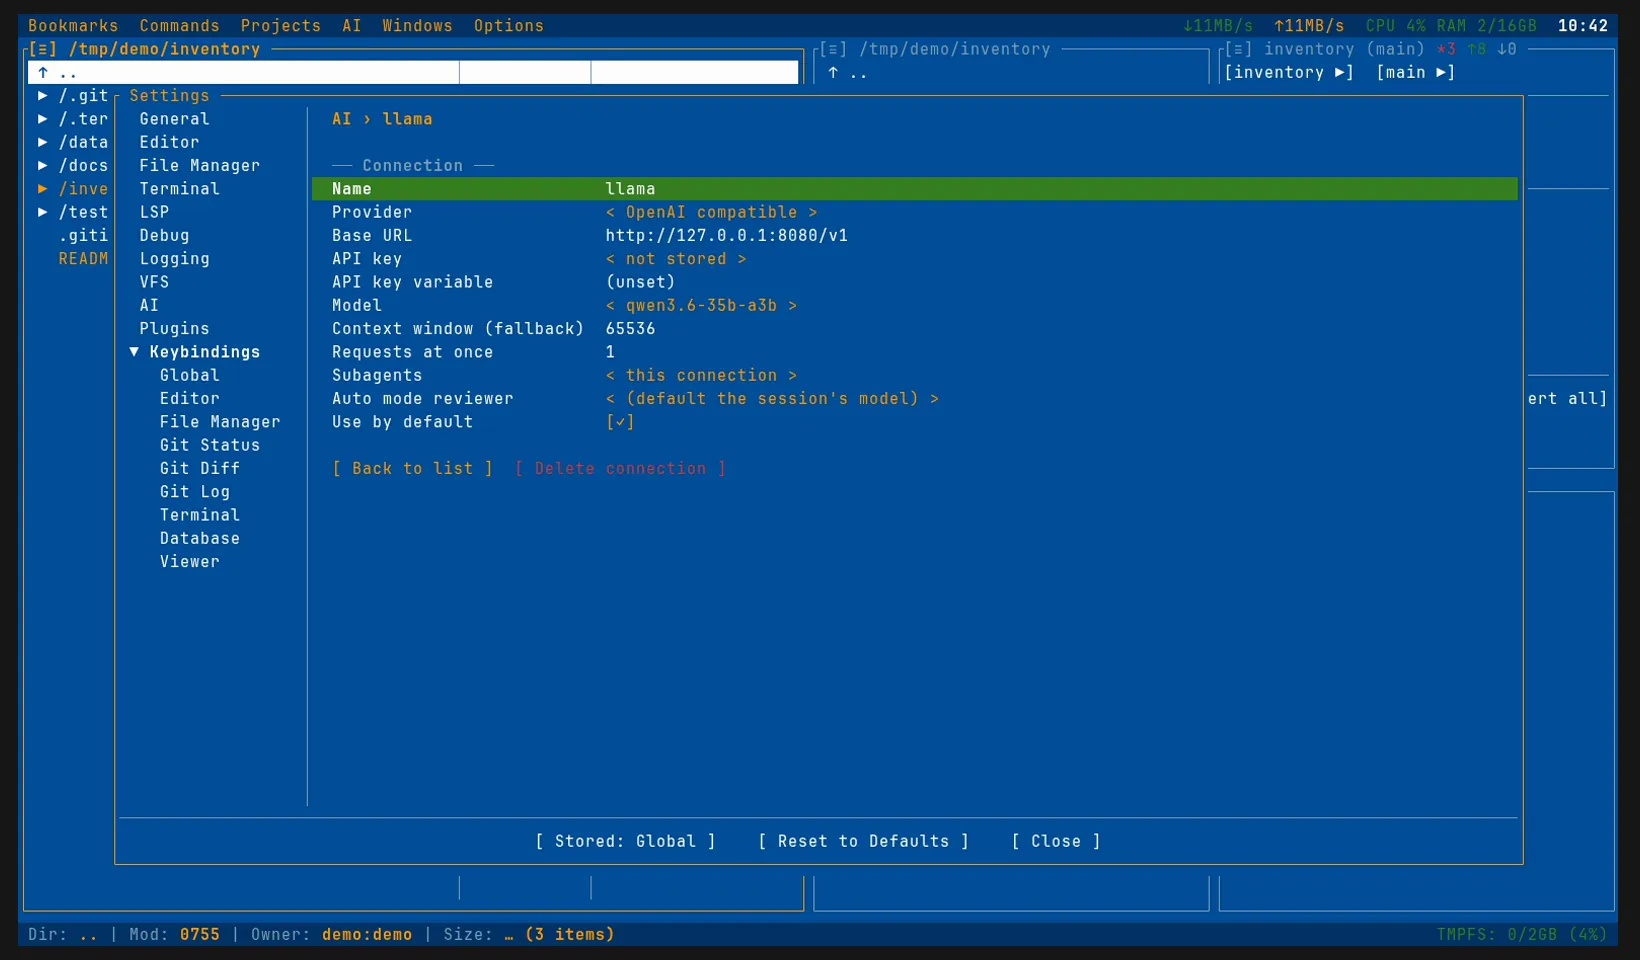
То же самое в config.toml:
[ai]
connection = "llama"                 # подключение для новых сессий

[ai.connections.llama]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8080/v1"
model = "qwen3.6-35b-a3b"            # --alias; пусто: первая модель из списка
context_window_fallback = 65536      # -c у llama-server
max_concurrent_requests = 1          # его слоты
# api_key_env = "LLAMA_API_KEY"      # переменная с его --api-key
Первый запрос
Откройте агентную панель клавишами Alt+A. Пока не пришёл первый токен модели, панель показывает, сколько промпта llama-server уже прочитал: termide запрашивает прогресс обработки промпта, а llama-server сообщает его по ходу дела.
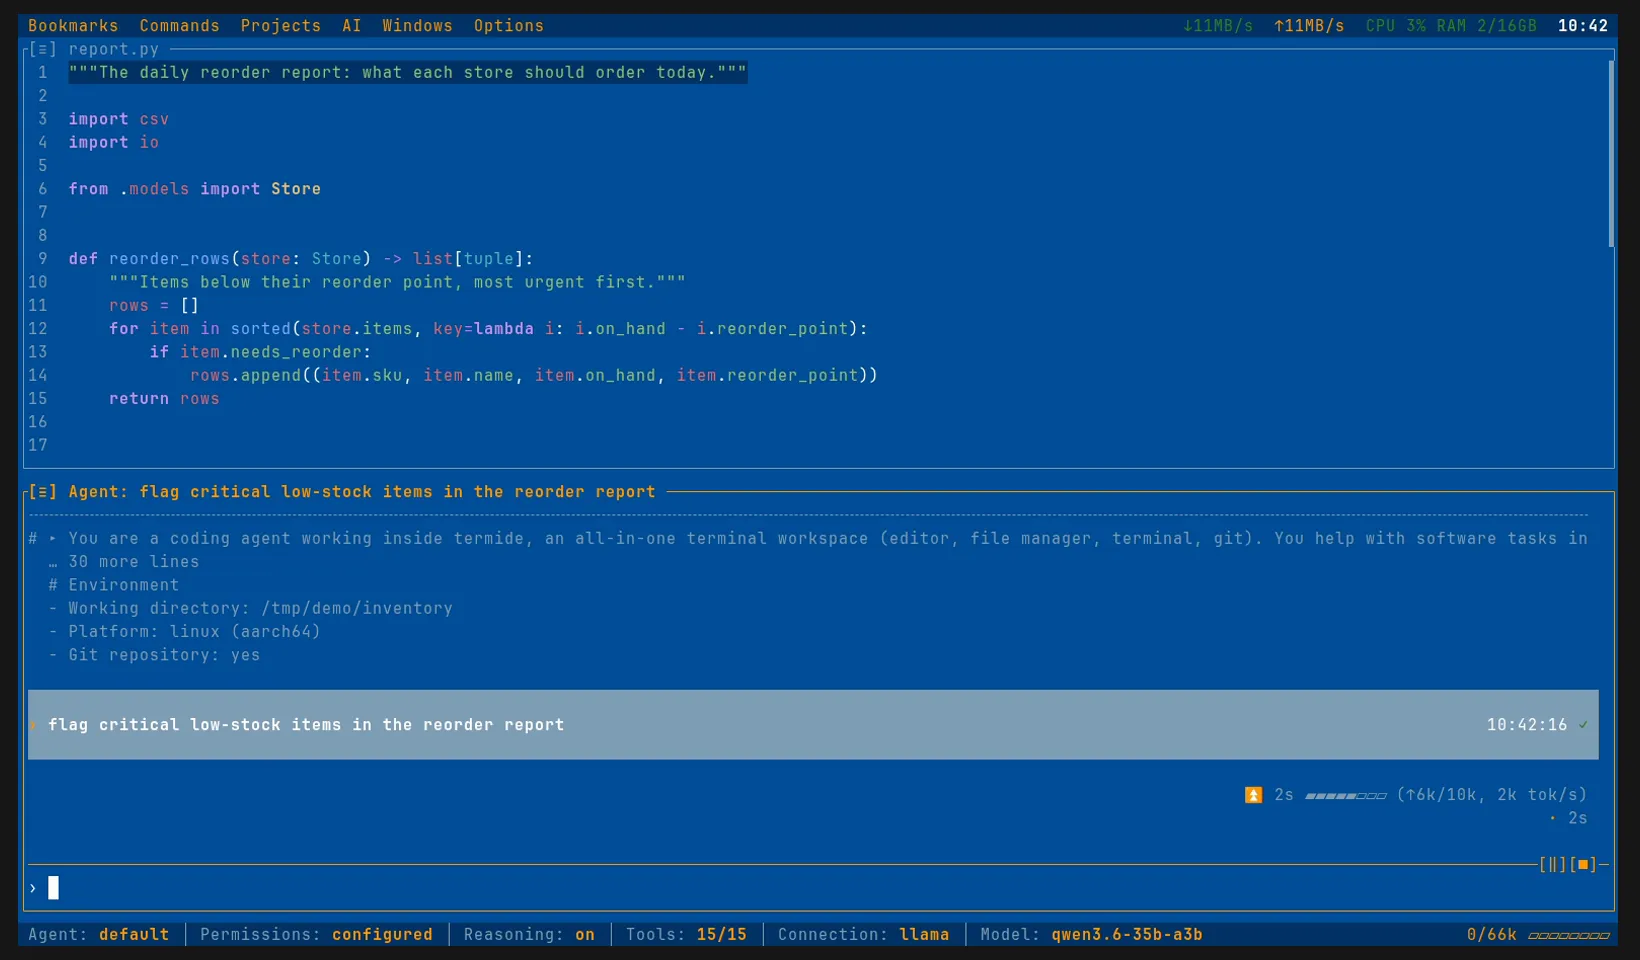
У локальной модели prefill часто самая медленная часть: системный промпт и схемы инструментов — уже несколько тысяч токенов, а длинная сессия — десятки тысяч. llama-server держит прочитанное в кэше, поэтому следующий запрос того же разговора читает только добавленное с прошлого раза, и полоска это показывает: ↑360 вместо ↑10k. Завершённый блок сохраняет цифры prefill и генерации: сколько длилась каждая, сколько токенов и с какой скоростью.
Чип Рассуждения включает и выключает размышления модели: termide передаёт его как enable_thinking шаблона чата, который читают шаблоны Qwen, GLM и DeepSeek. Выключенные — модель отвечает быстрее и тратит меньше токенов; включённые — сначала планирует, что обычно нужно задаче из нескольких шагов. В пределах одного запроса termide возвращает модели её рассуждения на каждом шаге, так что между чтением и правкой она не теряет собственный план.
Сообщение, набранное во время работы агента, присоединяется к прогону на его следующем шаге, а /pause останавливает прогон между шагами.
Агент termide, ваша модель
Всё, что делает агент, — от termide: системный промпт (который читает ваш AGENTS.md), инструменты — read, edit, shell, терминальные сессии, веб, recall, — настроенные вами MCP-серверы, навыки и правила разрешений. Модель только выбирает, что вызвать. Небольшая модель ошибается в этом чаще передовой, поэтому карточки разрешений и /undo здесь значат больше.
Держать контекст в пределах окна — тоже дело termide. Ближе к окну, при окне минус reserve_tokens, termide просит модель пересказать старую часть сессии, оставляя последние сообщения как есть; /compact делает это по запросу:
[ai.compaction]
enabled = true              # сжимать автоматически у границы окна
reserve_tokens = 16384      # начинать, когда контекст превысит окно минус это
keep_recent_tokens = 4096   # последние сообщения, сохраняемые дословно
read отдаёт агенту картинку как изображение, поэтому для скриншота нужна визуальная модель с её проектором (--mmproj, или его скачает -hf); сервер чисто текстовой модели такой запрос отклонит.
Слоты
llama-server выполняет одновременно столько запросов, сколько у него слотов (--parallel). К модели обращается не только панель: поручённые задачи, ревьюер auto, заголовок сессии и другие панели — тоже. Запрос сверх числа слотов либо ждёт на сервере, либо занимает слот, кэш которого был нужен другому разговору, и тому приходится читать свой промпт заново целиком.
Запросов одновременно (max_concurrent_requests) держит это под контролем: поставьте число слотов, и остальное termide выстроит в очередь сам, в порядке поступления. Запрос в очереди показывает ⏳ с тем, сколько он ждёт и сколько запросов перед ним, а Esc снимает его до отправки.
С --parallel слоты делят окно -c: каждому достаётся -c, делённое на число слотов, если сервер не работает с общим кэшем (--kv-unified). Контекстное окно (запасное) — это то, что может занять один запрос, поэтому указывайте долю одного слота.
Разрешения и режим auto
Чип Разрешения (или Shift+Tab) работает как на любом подключении: ask, configured, plan, edit, all и auto, и каждый вызов termide решает сам — режимов агента сервера, на которые их можно было бы перевести, здесь нет.
В auto ревьюер по умолчанию работает на модели самой сессии: ещё один запрос перед каждым действием, которое он решает, через те же слоты. Чтение, правки внутри проекта и команды, которые только смотрят, до него не доходят. Обычно для этого берут маленькую быструю модель: запустите её вторым llama-server и назовите её подключение ревьюером этого:
[ai.connections.llama]
# …
reviewer = "llama-small"             # его ревьюер auto; по умолчанию: [ai.auto_reviewer]

[ai.connections.llama-small]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8081/v1"
context_window_fallback = 16384
max_concurrent_requests = 1
Когда что-то пошло не так
- Сервер остановлен или перезапускается: прогон завершается с Модель недоступна, а карточка предлагает Повторить сейчас, Повторять, пока не получится и Остановиться. Для
/goalили/loopбез присмотра поставьте При лимите или сбое сети (on_limitв[ai]) вwait. - Контекст заполнен: llama-server отклоняет промпт больше своего окна, и termide сам сжимает сессию и пробует ещё раз. Если и это не помогло, карточка предлагает Сжать контекст и повторить. Такой отказ обычно значит, что Контекстное окно (запасное) задано больше, чем у сервера.
Сессии и расходы
Счёта нет, но токены всё равно стоят времени. Сведения о сессии (F3 или /usage) раскладывают их по тому, кто их потратил, — разговор, подагенты, ревьюер auto, сводки, — а строка статуса считает вход, чтение из кэша и вывод сессии (↑11k ↻30k ↓460) рядом с контекстом и его окном (11k/66k). Большой ↻ по сравнению с ↑ — это работа кэша llama-server.
Полезно знать
- Сервер может быть и не здесь. llama-server на арендованной машине работает так же: запустите его с
--host 0.0.0.0и--api-keyи укажите его в Базовом URL. Переключатель рассуждений, запрос прогресса и возврат рассуждений termide отправляет любому серверу, кроме hosted API, каким бы ни был его адрес, и не отправляет поле, которое сервер отклонил. - termide песочницы не даёт. Его разрешения — это контроль, а не изоляция: разрешённое выполняется с вашими правами.
- llama.cpp — лишь пример. То же OpenAI-совместимое подключение работает с vLLM, Ollama, LM Studio или hosted API вроде OpenAI и OpenRouter, а
provider = "anthropic_compatible"— с Anthropic-совместимым. omlx — ещё один локальный пример, для Mac. - Другие подключения: Claude Code, Codex и Gemini CLI приносят своих агентов и подписки; подключение к llama.cpp — хорошее второе, на которое можно перевести сессию, когда у них кончился лимит.
- Подробности — в руководстве по агенту.