omlx в агентной панели
oMLX отдаёт модели вашего Mac агенту termide, который берёт у него окно каждой модели, показывает prefill и переключает модели прямо в сессии
oMLX запускает модели на Apple Silicon через MLX из приложения в строке меню: несколько моделей на одном сервере, загружаемые по мере запросов, и кэш промптов, который из памяти переходит на SSD и переживает перезапуск. Он говорит на OpenAI chat API, и агентная панель termide умеет на нём работать.
Как и llama.cpp, сервер своего агента не приносит: агента ведёт termide — его системный промпт, инструменты, проверки разрешений и сжатие контекста, — а oMLX отвечает на обращения к модели. Этот гайд — о том, что свойственно именно oMLX; общее для любого локального сервера описано в гайде по llama.cpp.
Что понадобится
- Mac на Apple Silicon с macOS 15 или новее.
- oMLX: приложение со страницы релизов или Homebrew (
brew tap jundot/omlx https://github.com/jundot/omlxиbrew install jundot/omlx/omlx, затемomlx start). Сервер слушает порт 8000. - Модель, которая вызывает инструменты, скачанная из панели администрирования (
http://localhost:8000/admin) или положенная в его каталог моделей (~/.omlx/models): Qwen, GLM, Gemma и подобные. Агент работает только через вызовы инструментов.
Добавьте подключение
Откройте настройки клавишами Alt+P и перейдите на вкладку AI. Первым идёт раздел Подключения. + Добавить подключение добавляет OpenAI-совместимое; на его странице:
- Базовый URL:
http://127.0.0.1:8000/v1. - Модель: termide спрашивает у oMLX его модели, и тот показывает все из своего каталога, загруженные и нет.
- Контекстное окно (запасное): оставьте пустым. oMLX сообщает окно каждой модели, и панель берёт его при запуске и при каждой смене модели, так что
Context:совпадает с тем, что разрешает сервер. - Запросов одновременно: оставьте без ограничения. oMLX сам объединяет запросы в пакеты, по умолчанию до восьми за раз; задавайте поле, только чтобы termide не превышал меньшее значение
--max-concurrent-requests. - Ключ API: основной ключ API oMLX, если вы не отключили его проверку для localhost. Ключ уходит в зашифрованное хранилище termide, а не в
config.toml. - Использовать по умолчанию: отметьте, и новые агентные панели будут открываться на oMLX.
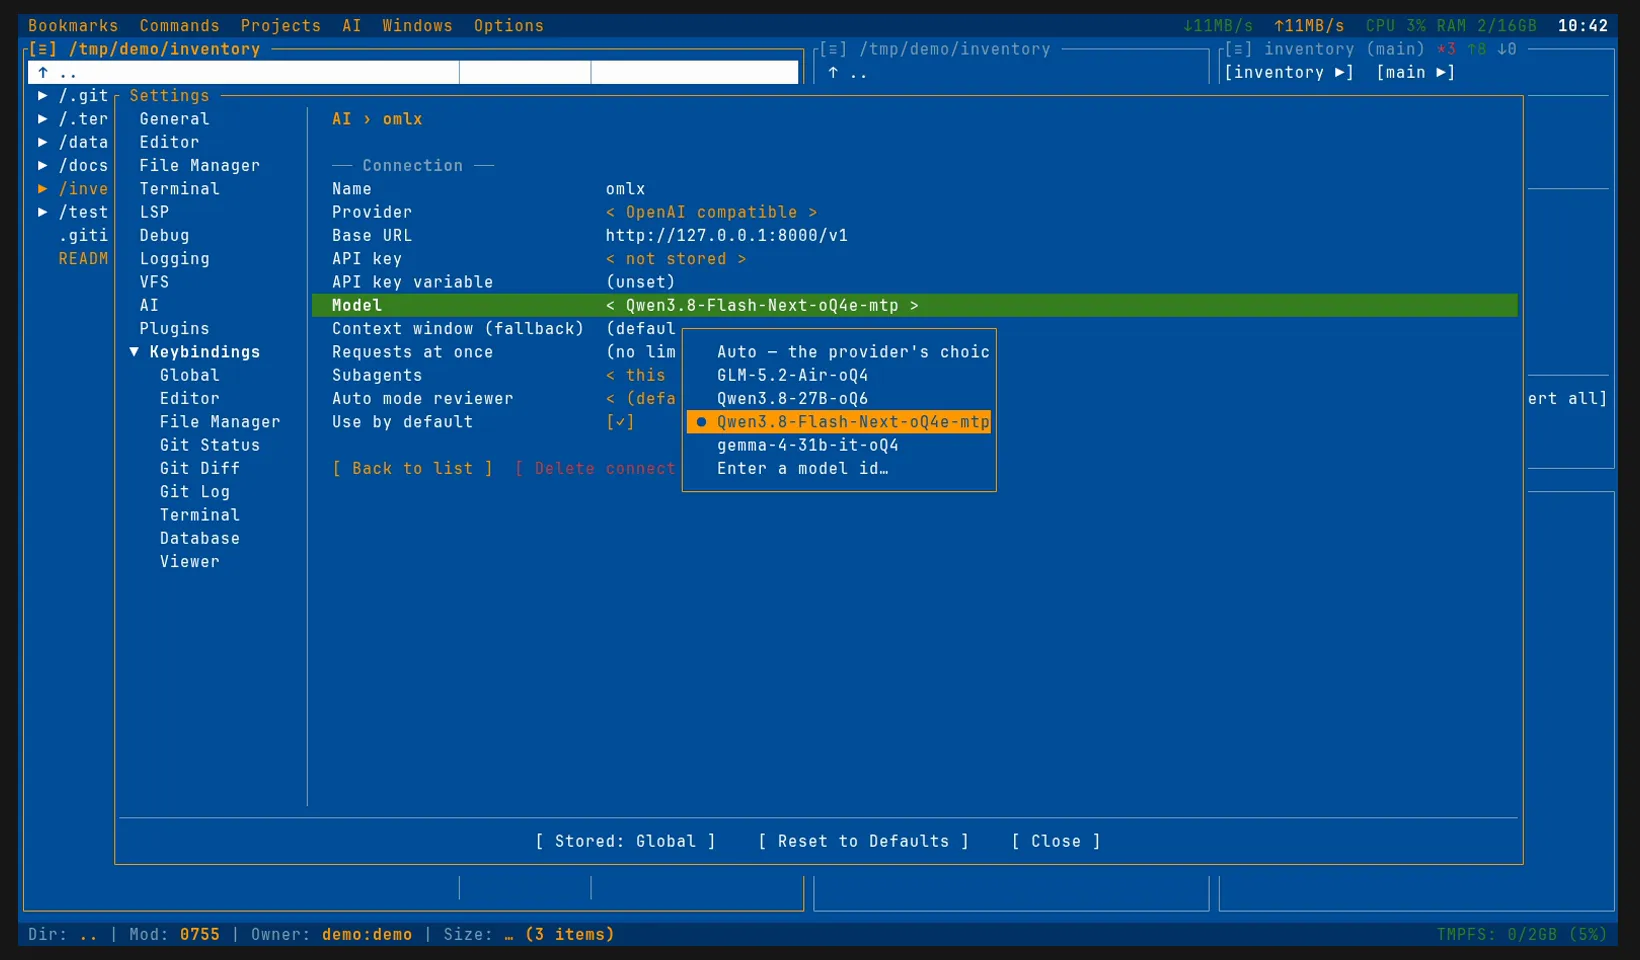
То же самое в config.toml:
[ai]
connection = "omlx"                  # подключение для новых сессий

[ai.connections.omlx]
provider = "openai_compatible"
base_url = "http://127.0.0.1:8000/v1"
model = "Qwen3.8-Flash-Next-oQ4e-mtp" # пусто: первая модель из списка
# api_key_env = "OMLX_API_KEY"       # переменная с его основным ключом API
oMLX отдаёт и Anthropic Messages API, но брать стоит OpenAI-совместимое подключение: именно там termide читает окна моделей и прогресс prefill.
Первый запрос
Откройте агентную панель клавишами Alt+A. До первого токена панель показывает prefill: oMLX 0.7.1 и новее сообщают прогресс обработки промпта так же, как llama.cpp, и панель рисует полоску с числом прочитанных токенов и скоростью по тем, что не взяты из кэша. Для более старого oMLX вместо неё — прошедшее время и оценка размера промпта.
Чип Рассуждения включает и выключает размышления модели через enable_thinking шаблона чата, а в пределах одного запроса termide возвращает модели её рассуждения на каждом шаге — как на любом локальном сервере.
Несколько моделей, один сервер
Чип Модель в строке статуса показывает модели сервера и переключает между ними сессию; переключение действует со следующего запроса и остаётся за сессией. oMLX загружает модель, когда её впервые просят, поэтому такой запрос включает и время загрузки, а при нехватке памяти выгружает ту, к которой дольше всего не обращались; модели, которыми пользуетесь каждый день, закрепите в его панели, чтобы они оставались загруженными.
В списке видно ещё две особенности oMLX:
- Псевдонимы. Модель, которой в панели дан псевдоним, показывается под ним.
- Профили. Профиль, открытый как модель, показывается как
<модель>:<профиль>, напримерqwen3-8b:thinking: та же загруженная модель с настройками профиля, которую можно выбрать для сессии из чипа.
Кэш промптов oMLX держит в памяти, а сверх неё — на SSD, даже после перезапуска сервера. Поэтому открытая заново длинная сессия читает большую часть промпта из кэша, а не обрабатывает его снова: в строке статуса это видно как большой ↻ рядом с маленьким ↑.
Маленькая модель для проверок
В режиме auto ревьюер решает то, на что иначе появилась бы карточка разрешения: ещё один запрос перед каждым таким действием. По умолчанию он работает на модели самой сессии. С oMLX его может взять меньшая модель того же сервера, без второго сервера:
[ai.auto_reviewer]
connection = "omlx"   # пусто: подключение сессии
model = "gemma"       # его модель: по id или его части
Модель ревьюера остаётся загруженной рядом с моделью сессии, так что оставьте в памяти место для обеих.
Остальное — от termide
Всё прочее работает как на любом локальном сервере, и гайд по llama.cpp проходит это по порядку: собственный системный промпт и инструменты termide, сжатие контекста у границы окна, режимы разрешений, что делает панель, когда сервер недоступен или контекст заполнен, и как сведения о сессии считают токены.
Полезно знать
- Сервер может быть на другом Mac. Слушать за пределами loopback без основного ключа API oMLX отказывается: задайте ключ, запустите его с
--host 0.0.0.0и укажите тот Mac в Базовом URL. - oMLX — лишь пример. То же OpenAI-совместимое подключение работает с llama.cpp, vLLM, Ollama, LM Studio или hosted API вроде OpenAI и OpenRouter, а
provider = "anthropic_compatible"— с Anthropic-совместимым. - termide песочницы не даёт. Его разрешения — это контроль, а не изоляция: разрешённое выполняется с вашими правами.
- Другие подключения: Claude Code, Codex и Gemini CLI приносят своих агентов и подписки; подключение к oMLX — хорошее второе, на которое можно перевести сессию, когда у них кончился лимит.
- Подробности — в руководстве по агенту.